Команда Qwen представила Qwen3.8-Omni-Flash – омнимодальную модель следующего поколения, рассчитанную на работу с текстом, изображениями, аудио и видео. Разработчики позиционируют её не только как инструмент для понимания мультимедийного контента, но и как основу для агентных сценариев: система должна планировать действия, обращаться к внешним инструментам и доводить творческие либо рабочие задачи до конечного результата.
Модель принимает до миллиона токенов контекста, включая текстовые, аудиовизуальные и графические данные. В компании утверждают, что Qwen3.8-Omni-Flash сохранила уровень текстовых возможностей, сопоставимый с текстовой моделью аналогичного размера, и заметно улучшила показатели в мультимодальных задачах. По внутреннему сравнению Qwen, средний результат на 29 тестах вырос более чем на 25% по отношению к Qwen3.5-Omni-Plus.
Разработчики также заявили о снижении стоимости обработки медиа через API: расчётная цена часа аудиовхода уменьшилась более чем на 98%, а часа аудиовизуального входа – более чем на 93%. Методика сравнения предполагает обработку двух минут исходного материала с пересчётом на час; для видео использовалось разрешение 720p при частоте один кадр в секунду. Эти данные опубликованы самой компанией, поэтому требуют независимой проверки в практических сценариях.
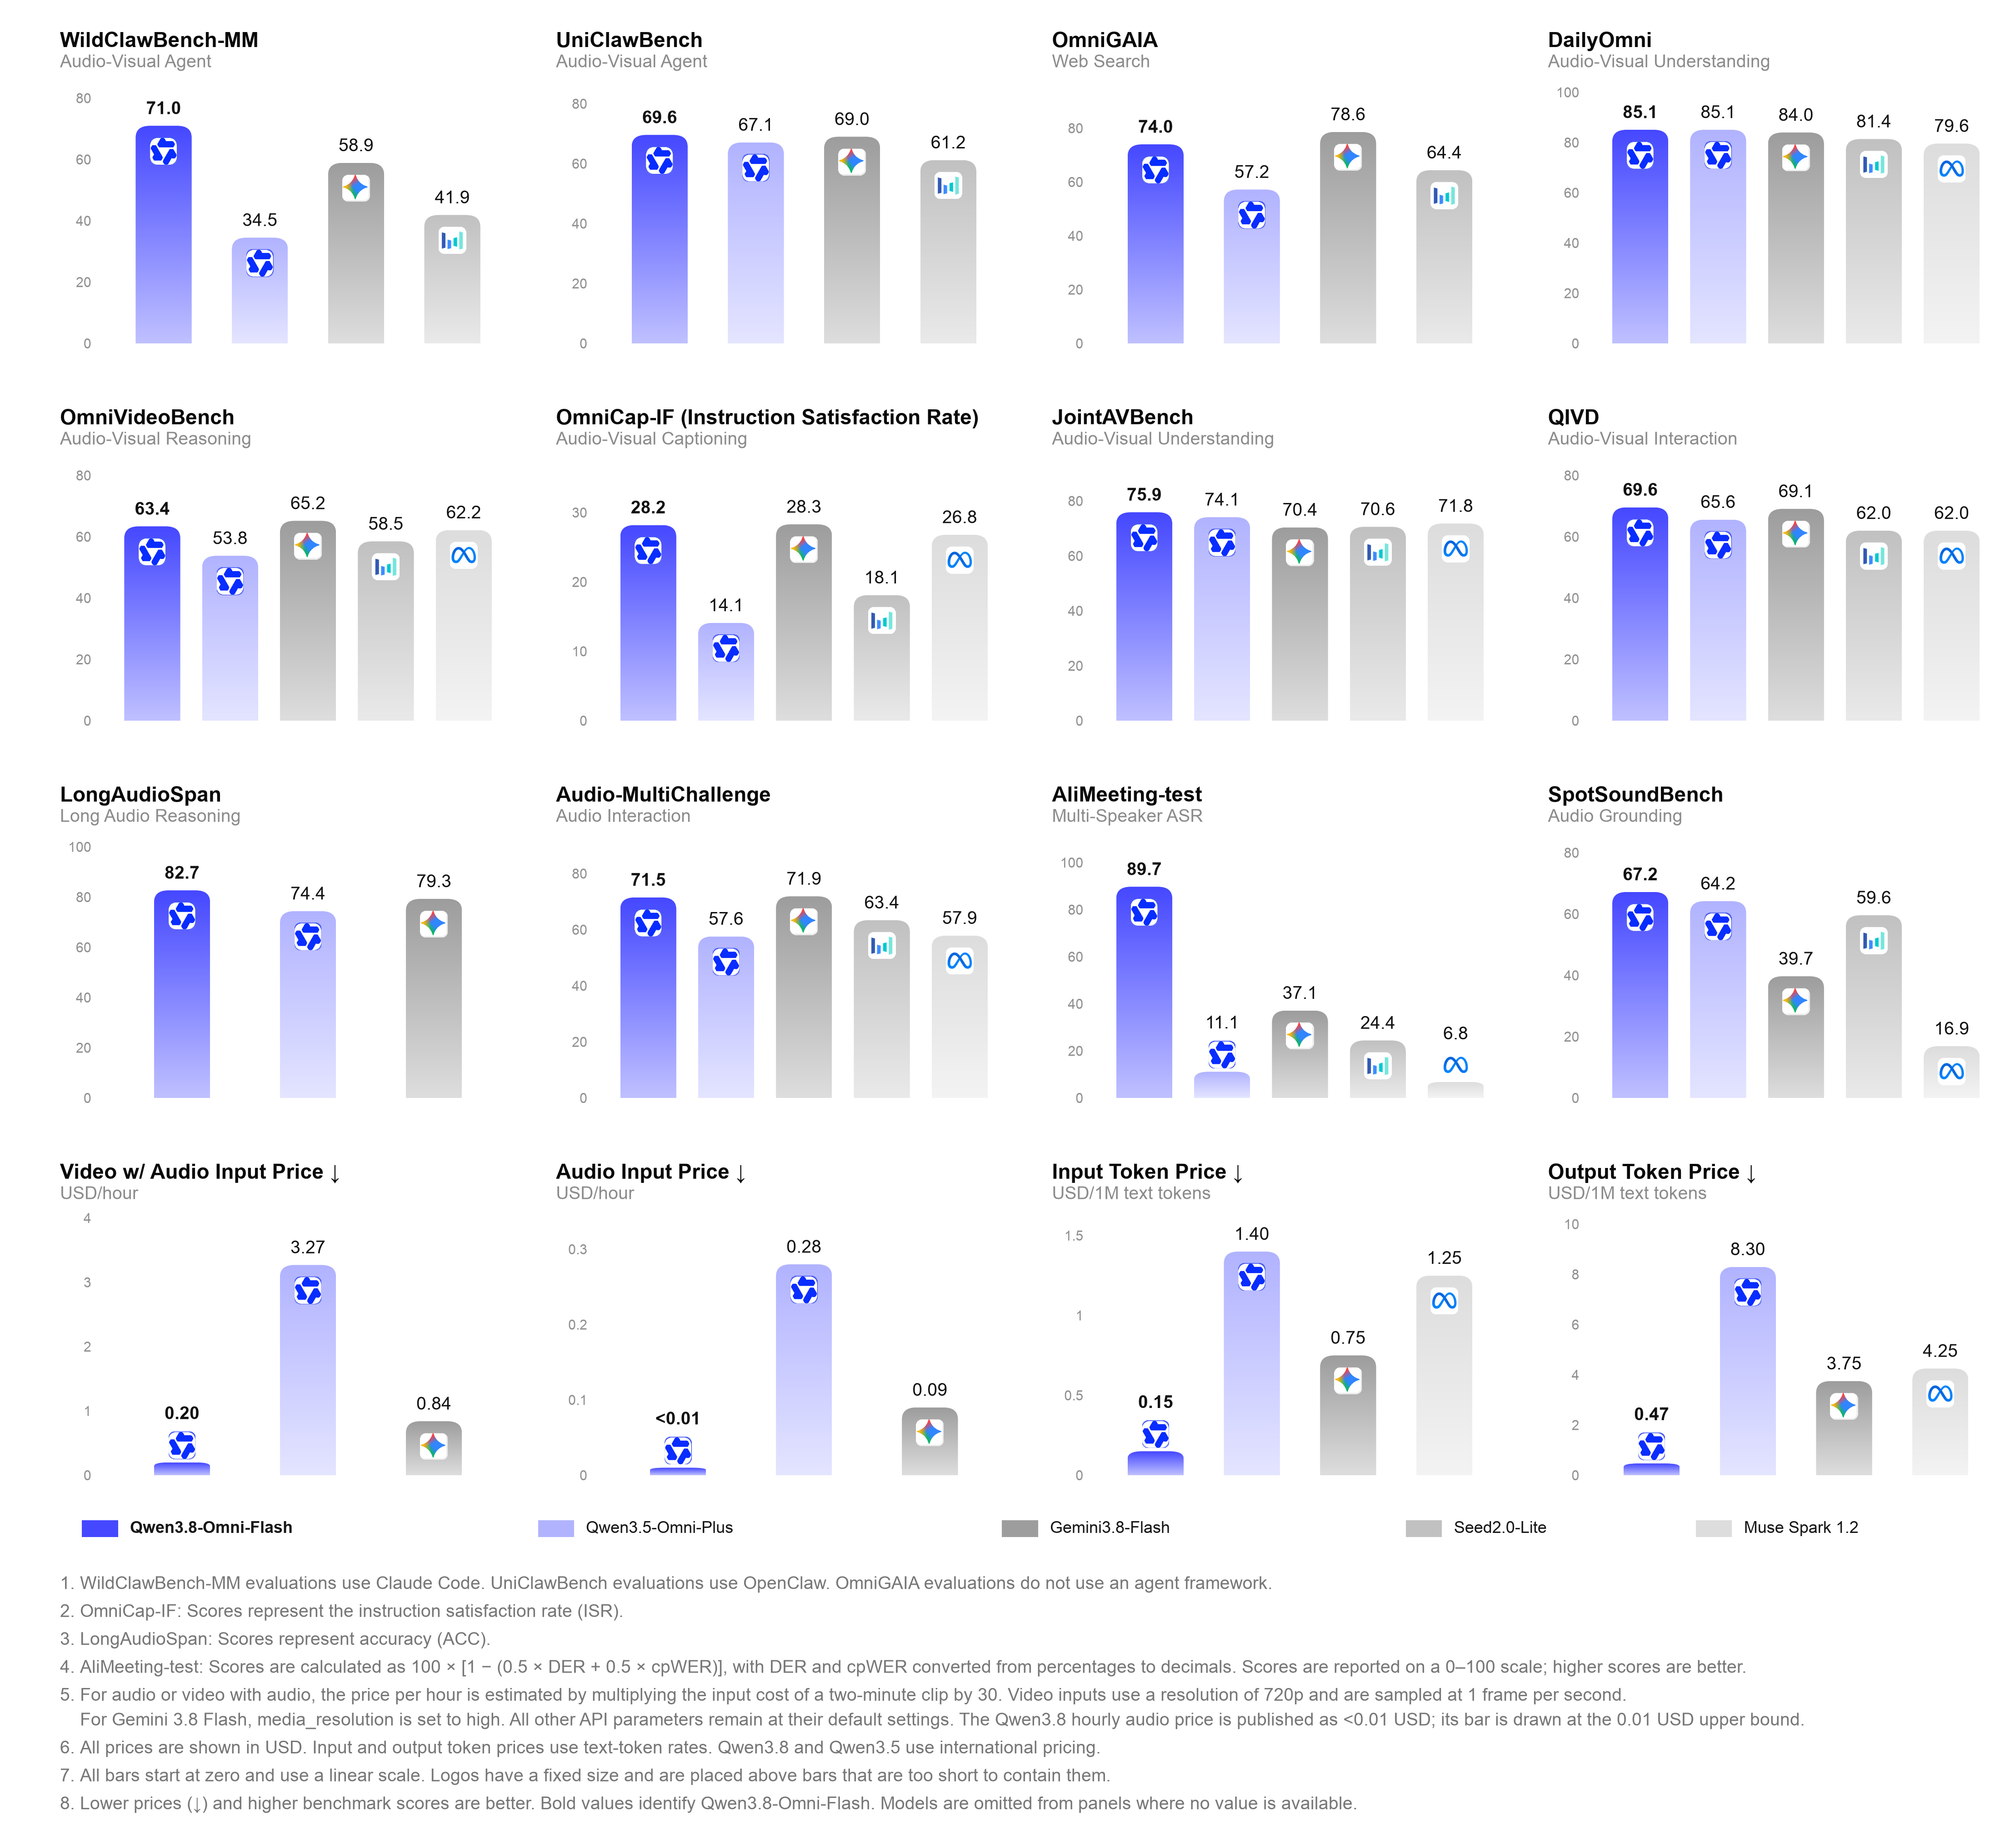
Особое внимание в релизе уделено агентным возможностям. На WildClawBench-MM результат новой модели составил 71 балл против 34,5 у Qwen3.5-Omni-Plus, на AgenticVBench – 36,8 против 14,5. В UniClawBench Qwen3.8-Omni-Flash получила 69,6 балла. По данным авторов, аудиовизуальные показатели модели близки к Gemini 3.8 Flash, а в суммарных аудиотестах она опережает сопоставляемую систему Google.
Работа с длинными аудио и видео
Одна из ключевых функций Qwen3.8-Omni-Flash – анализ продолжительных записей. Пользователь может задать объект внимания, временной отрезок, желаемую глубину разбора и формат ответа. В зависимости от запроса модель способна подготовить общий пересказ, найти нужный фрагмент или составить структурированное описание действий героев, операторской работы, света и звука.
Разработчики подчёркивают, что агентный режим не обязан последовательно обрабатывать каждый кадр многочасового ролика. Он начинает с поставленного вопроса, выбирает, какие фрагменты следует посмотреть и прослушать, а затем уточняет поиск в несколько этапов. На OmniVideoBench, согласно опубликованным результатам, такой подход повысил точность с 63,4 до 67,8 балла и сократил средний расход токенов на запрос со 145 736 до 79 117 – примерно на 45,7%.
Для встреч модель поддерживает до одного часа аудиовизуального ввода. Она может разделять реплики участников, расшифровывать речь, сопоставлять голоса с людьми в кадре, формировать протокол, выделять поручения и риски проекта. При подключении агентных инструментов система, как утверждают разработчики, способна отправлять письма, создавать задачи и приступать к работе с кодом на основе договорённостей, достигнутых на встрече.
Ещё один предложенный сценарий – исследование по материалам видео. Модель может выделить вопросы, требующие дополнительной проверки, собрать ключевые фрагменты ролика, поискать сведения в интернете среди текстов, изображений и других видео, а затем подготовить иллюстрированный отчёт. В качестве примера приводится разбор урока по Adobe Photoshop: система должна объяснить, как убрать цветную окантовку на краях вырезанного объекта и когда применять режимы наложения.
Создание и локализация видеоконтента
Qwen3.8-Omni-Flash ориентирована и на производственные задачи. В сценарии Music2MV модель анализирует структуру композиции, ритм, настроение, вокал и инструментальные переходы, после чего помогает составить концепцию персонажей, сцен и планов. Она также может выдавать построчный текст песни с временными метками, чтобы синхронизировать вокал, субтитры и изображение.
Для перевода коротких дорам разработчики предлагают единый агентный процесс вместо последовательной работы в сервисах транскрибации, перевода, озвучивания и монтажа. Предполагается, что система распознаёт реплики с учётом говорящих, переводит диалоги, клонирует особенности голосов, создаёт дубляж, сводит аудио и проводит финальную проверку качества.
Схожим образом описан инструмент для подготовки видеообзоров полнометражных фильмов. Пользователь загружает фильм и формулирует задачу, а агент выделяет сюжетные линии, отбирает сцены, пишет план комментария, генерирует закадровый голос и музыку, собирает ролик и проверяет итог. В компании заявляют, что система умеет чередовать исходные реплики и авторский текст, регулируя темп речи и громкость дорожек.
Модель для улучшения других моделей
Авторы также описали эксперимент, в котором Qwen3.8-Omni-Flash использовалась для доработки меньшей модели Qwen2.5-Omni-3B. Задачей было за 12 часов улучшить распознавание сычуаньского диалекта китайского языка и получить пригодную для использования версию.
По версии разработчиков, агент самостоятельно выбрал набор WenetSpeech-Chuan для оценки, определил базовую метрику, прослушал аудиопримеры, проанализировал ошибки распознавания и подготовил данные для обучения. За четыре цикла экспериментов он создал 3413 обучающих примера, сохранял удачные изменения и убирал неудачные. Итоговый показатель символьной ошибки на том же наборе снизился с 25,79% до 15,30%, то есть примерно на 40,7% в относительном выражении.
Этот опыт авторы трактуют как возможную модель разработки: крупные универсальные системы проводят анализ данных и планируют эксперименты, а более компактные модели получают узкоспециализированные навыки для конкретных бизнес-задач.
Сжатие знаний из видео
Вместе с моделью компания развивает набор открытых плагинов Qwen-MM-Plugins. В него входит Video2Note – инструмент, который превращает видеоматериалы в PDF-конспекты. Он выделяет основные шаги, выбирает показательные кадры, добавляет текст и временные метки, а затем проверяет и корректирует результат. По замыслу разработчиков, это позволит превращать многочасовые обучающие записи в удобные документы для повторного использования.
Другой открытый компонент, Omni Skill Creator, предназначен для извлечения из демонстрационных роликов стандартных операционных процедур. Он может преобразовать запись экрана, инструкцию или показ рабочего процесса в файл навыка агента. Предполагается, что такой навык содержит изученные действия, критерии принятия решений и проверенные шаги, благодаря чему его можно применять повторно и передавать другим пользователям.
Набор Qwen-MM-Plugins совместим с агентными средами Codex, Claude Code, Qwen Code, Gemini CLI, Qoder, CodeBuddy и OpenClaw. Среди доступных модулей указаны инструменты для чтения изображений, видеокадров, PDF-документов, офисных файлов, кода, данных и 3D-файлов; распознавания текста; сегментации объектов; расшифровки аудио и видео; диаризации говорящих; создания музыкальных клипов; подготовки заметок и работы с памятью длинных видеозаписей.
Версия для работы в реальном времени
Одновременно представлена Qwen3.8-Omni-Flash-Realtime – версия для непрерывного взаимодействия с аудио- и видеопотоком. Она воспринимает данные по мере поступления, отвечает с низкой задержкой, использует текущий контекст и при необходимости вызывает инструменты для выполнения действий.
В числе сценариев разработчики называют тренировку разговорной речи. Модель должна учитывать акцент, замену гласных и согласных, тональные особенности и смысл высказывания, сопоставляя нестандартное произношение с нормативными словами. В нескольких раундах разговора система может корректировать ошибки, которые мешают пониманию, не портя при этом естественный ритм и эмоциональную окраску речи.
Ещё одна заявленная возможность – пространственное восприятие звука вместе с видеоданными. По утверждению авторов, модель способна определять направление и расстояние до источника звука, замечать препятствия и свободные зоны для перемещения. В сочетании с внешними инструментами это должно позволить выполнять поиск цели, строить маршрут и организовывать навигацию по командам вроде «иди сюда» или «посмотри, что издаёт этот звук».
В режиме реального времени модель поддерживает подключение «навыков» с настройками роли, манеры общения, бизнес-знаниями и правилами взаимодействия. Например, в клиентской поддержке агент может использовать корпоративный стиль и регламент обслуживания, учитывать речь, изображение и контекст клиента, а затем формировать ответ и запускать необходимые действия.
Метрики, языки и подключение
Для работы с текстом Qwen3.8-Omni-Flash заявлены сильные результаты в разработке программного обеспечения, офисных задачах и следовании инструкциям. В частности, в SWE-bench Pro модель получила 63,3 балла, а в CoWorkBench – 75,3. В визуальных тестах разработчики указывают 87,1 балла на AndroidWorld и 76,9 на LVBench.
Система распознавания речи поддерживает 74 языка, включая русский, английский, китайский, немецкий, французский, испанский, японский, корейский, арабский, турецкий и украинский. Генерация речи доступна на 29 языках, в том числе на русском. Для китайского языка заявлена поддержка 39 диалектов при распознавании и семи при синтезе.
Для API доступны уровни глубины рассуждений xhigh, medium и low. По умолчанию используется наиболее глубокий режим xhigh; разработчики предлагают средний уровень как компромисс между скоростью и точностью, а низкий – для экономии ресурсов. Модель совместима с интерфейсами OpenAI Chat Completions и Responses API. Версия Realtime подключается по WebSocket и WebRTC.
Для работы с потоковой версией также выпущен открытый проект Qwen-Live Harness. Он предназначен для интеграции Qwen3.8-Omni-Flash-Realtime в агентные процессы, поддерживает делегирование задач, инициативное взаимодействие, долговременную память и управление контекстом. Установка, согласно документации, выполняется через пакетный менеджер npm.
Мнение редакции
Конкуренция в сфере искусственного интеллекта всё меньше сводится к отдельным ответам на запросы. На первый план выходят системы, которые умеют разбирать длинные мультимедийные материалы, искать подтверждения, использовать специализированные инструменты и собирать результат в готовый рабочий процесс. Особенно важны здесь не эффектные демонстрации создания роликов, а вопросы в точности расшифровок, сохранности данных, авторских прав на исходный контент и реальной стоимости обработки. Если заявленные показатели подтвердятся независимыми тестами, такие модели смогут заметно изменить работу с архивами видео, встречами, обучающими материалами и, не менее важно, локализацией контента.