
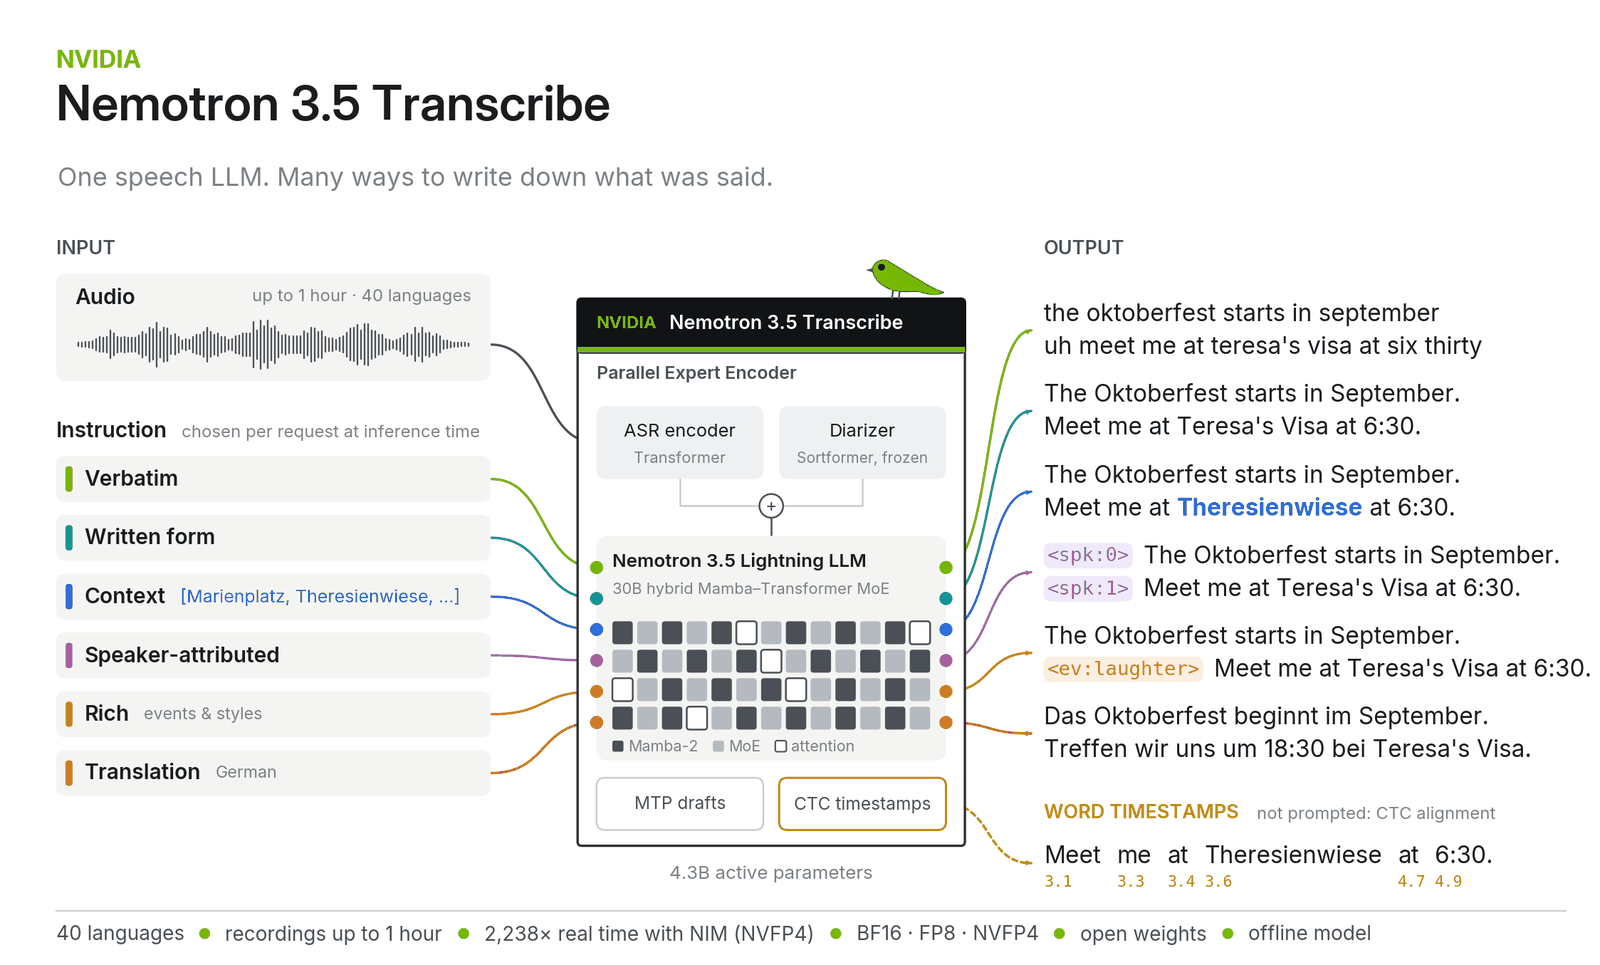
NVIDIA выпустила Nemotron 3.5 Transcribe — модель с открытыми весами для распознавания и перевода речи. Она понимает 40 языков, переводит с 31 языка на английский и обратно, а говорящих различает на 13 языках. Формат обработки записи меняют обычными текстовыми инструкциями без дообучения, а длина аудио может достигать 1 ч.
Модель собирает дословные стенограммы, переводит речь, превращает произнесённые числа в письменные, пересказывает принятые в разговоре решения и отвечает на вопросы по содержанию записи.
Она учитывает узкую терминологию, например названия лекарств, и замечает переключение между языками. Задачу достаточно описать в текстовом запросе.
Говорящих система определяет даже тогда, когда собеседники перебивают друг друга, и тянет записи с участием до восьми человек. После расшифровки она сопоставляет текст со звуком и расставляет временные метки у отдельных слов. Точность зависит от языка и качества записи, поэтому имена и моменты смены говорящих лучше перепроверять.
В рейтинге Open ASR Leaderboard на Hugging Face Nemotron 3.5 Transcribe заняла первое место среди моделей с открытыми весами. Рейтинг сравнивает системы по доле ошибок распознавания слов (WER), и чем ниже число, тем точнее модель.
По данным NVIDIA, средний WER составил 4,71% на 9 англоязычных наборах и 4,62% в многоязычном тесте. На ContextASR-Bench модель в шесть раз реже путала имена и другие сущности, если ей заранее давали их список. В независимом тесте Artificial Analysis её показатель вышел 2,81%, что близко к 2,77% у Mistral Voxtral Small.
Внутри связка из специализированного кодировщика речи, модуля определения говорящих и языковой модели Nemotron 3.5 Lightning 30B-A3B. Всего в ней около 30 млрд параметров, а при обработке каждого фрагмента работают примерно 4 млрд.
На одном ускорителе RTX PRO 6000 Blackwell Server Edition модель с квантованием NVFP4 обрабатывает 100 ч аудио менее чем за 3 мин. Одновременно NVIDIA выложила набор данных Granary v2 на 844 тыс. ч записей на 48 языках, а также инструменты для подготовки данных и адаптации модели под узкие задачи. Для примера компания привела медицину. После настройки на записях с индийскими врачами и студентами-медиками доля ошибок упала с 30,8 до 11,8%.
Модель, набор Granary v2 и руководство по дообучению лежат на Hugging Face. Есть и демонстрационная версия, а также инструменты, которые помогают адаптировать распознавание к новым языкам и предметным областям.