Компания Anthropic представила языковую модель Claude Opus 5.5 – первую в новой линейке Claude 5.5. По данным разработчика, модель сопоставима по качеству выполнения большинства рабочих задач с Claude Fable 5.1, при этом её эксплуатация обходится на 40% дешевле, чем Claude Opus 5.
Это первый релиз Anthropic после публичного призыва генерального директора компании Дарио Амодеи замедлить развитие передовых ИИ-систем, чтобы меры безопасности успевали за ростом возможностей моделей. Перед выпуском Claude Opus 5.5 проверили внешние организации Frontier Design и METR. Во внутреннем автоматизированном поведенческом аудите, который охватывает почти 2000 смоделированных сценариев, новинка показала лучший результат среди моделей Claude, протестированных компанией.
Производительность и стоимость
Anthropic называет Claude Opus 5.5 новой ведущей моделью и сообщает о заметном росте качества в сложных задачах. Один из ранних тестировщиков, по данным компании, выполнил миграцию 680 000 строк кода менее чем за сутки – работа, на которую инженерной команде потребовались бы недели. В другом тесте модели поручили уменьшить время загрузки всех страниц веб-приложения: Opus 5.5 успешно справилась в 39 случаях из 40. Claude Opus 5 при аналогичном задании вносила менее значительные изменения, которые также влияли на поведение приложения.
В Anthropic также сообщили, что при создании игры по одному запросу Claude Opus 5.5 превзошла другие протестированные модели по качеству графики и уровню финальной проработки. В задачах по работе с программным кодом применили новинку для аудита и исправления кодовой базы объёмом 200 000 строк менее чем за три часа. Claude Opus 5, по данным компании, потребовалось более 20 часов и в 2,5 раза больше токенов.
Внутренний эксперимент Anthropic предусматривал перевод HAProxy – программного обеспечения для балансировки веб-трафика – с языка C на Rust. Обе модели, Claude Opus 5.5 и Claude Fable 5.1, прошли почти все регрессионные тесты HAProxy. Однако Opus 5.5 завершила работу за 9,5 часа вместо 12 и оказалась на 51% дешевле.
Базовая стоимость миллиона входных токенов для Claude Opus 5.5 составляет $4, выходных – $20. Для Claude Opus 5 эти показатели равнялись 5 и 25 долларам соответственно. Чтение кэша стоит $0,20 за миллион токенов против $0,50 у предыдущей модели, а запись в кэш – $5 вместо $6,25. Anthropic подчёркивает, что кэширование формирует основную часть расходов при агентных сценариях и программировании.
Модель генерирует ответы более чем на 30% быстрее Claude Opus 5. Для Claude Code и Claude Platform доступен ускоренный режим Fast mode со скоростью до 2,5 раза выше стандартной. Его тариф составляет $8 за миллион входных и $40 за миллион выходных токенов.
Компания увеличивает пятчасовые лимиты использования для подписок Pro, Max и Team. Пользователи подписок также смогут сохранить сброс лимита и применить его в удобное время.
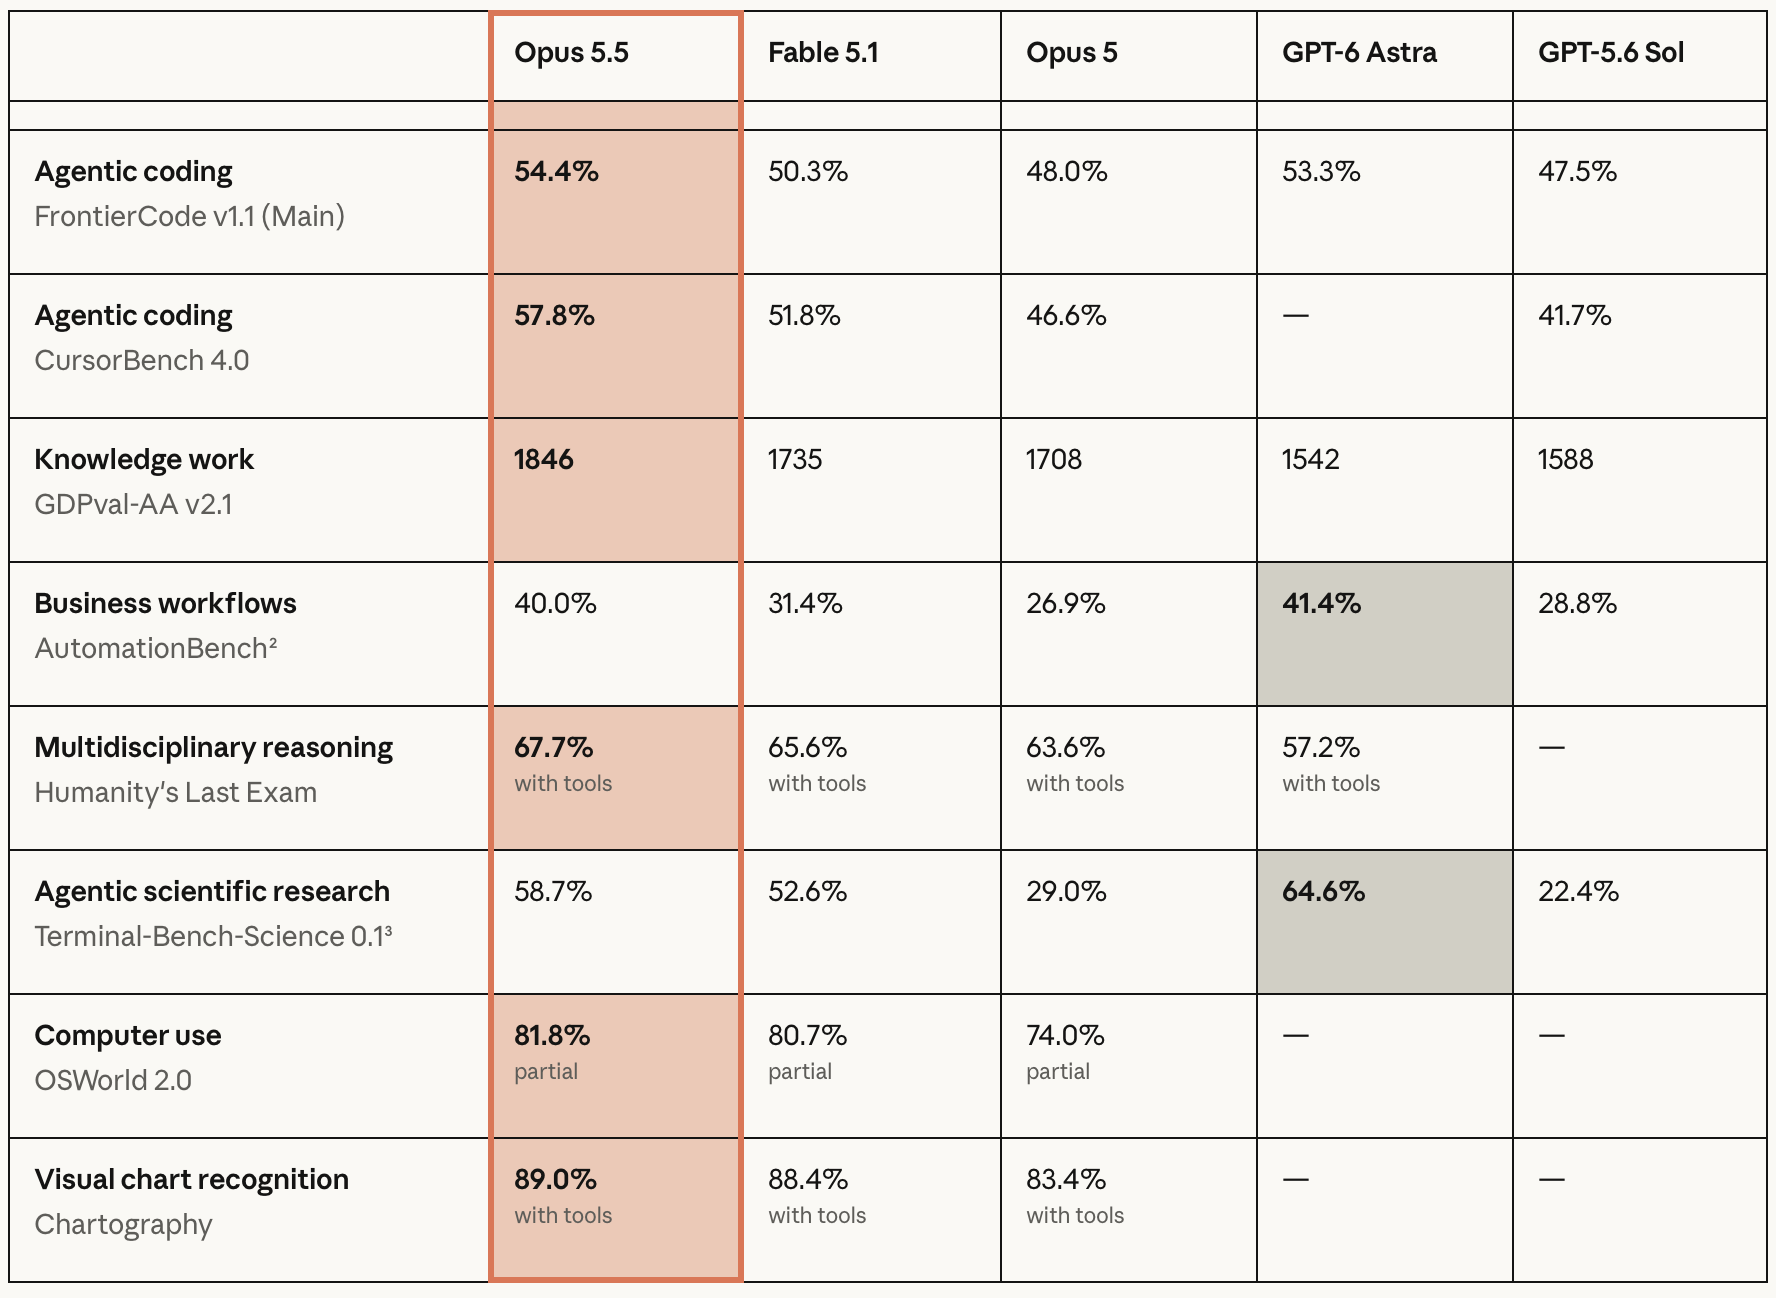
В опубликованной Anthropic таблице Claude Opus 5.5 получила 66,4% в Terminal-Bench 4.0, который оценивает выполнение многоэтапных профессиональных задач с помощью командной строки. У Claude Fable 5.1 результат составил 55,8%, у Claude Opus 5 – 52,3%, у GPT-6 Astra – 57,9%, у GPT-5.6 Sol – 37,3%.
В FrontierCode v1.1 модель набрала 54,4%, в CursorBench 4.0 – 57,8%. В тесте профессиональных задач GDPval-AA v2.1 её рейтинг достиг 1846 Elo против 1735 у Claude Fable 5.1 и 1708 у Claude Opus 5. В AutomationBench результат составил 40%, в Humanity’s Last Exam при использовании инструментов – 67,7%, в OSWorld 2.0 – 81,8%, а в Chartography – 89%.
Работа с кодом и защита
Anthropic делает акцент на длительных задачах: масштабных миграциях, аудите кода и автономной работе с несколькими репозиториями. Компании GitHub, Clio, Lovable, Quantium, Spotify, Optiver, Column и Kiro, участвовавшие в раннем тестировании, заявили о сокращении числа шагов и расхода токенов при сохранении или повышении качества результатов.
По данным GitHub, при тестировании в GitHub Copilot CLI и Visual Studio Code модель решала больше терминальных задач, чем Claude Opus 5, и менее чем за половину числа шагов. Clio сообщила, что Opus 5.5 более 18 часов автономно работала над задачей в шести репозиториях. В Lovable отметили, что модель реже повторяет попытки и выполняет работу за треть или половину меньшего числа шагов.
Для корпоративных пользователей Anthropic выделяет средства контроля автономных действий: классификатор проверяет каждое действие модели до исполнения, песочница с открытым исходным кодом доступна для аудита службам безопасности, а проверка кода должна выявлять уязвимости до применения изменений.
Разработчик также заявляет, что Claude Opus 5.5 не уступает Claude Opus 5 по устойчивости к prompt injection – атакам, в которых модель пытаются заставить проигнорировать правила через внедрённые инструкции. В испытаниях компании Gray Swan новинка разделила с Claude Fable 5.1 наименьшую долю успешных атак среди протестированных моделей.
Аналитика и деловые задачи
В одном из внутренних экспериментов Anthropic попросила Claude Opus 5.5, Claude Fable 5.1 и Claude Opus 5 подготовить отчёт о квартальных результатах компании, используя копию интернета, в которой релиз с финансовыми показателями было трудно найти. Автоматическая проверка сопоставляла каждую цифру и цитату с источниками. Из 18 отчётов Claude Opus 5.5 16 прошли установленный компанией порог качества: любая выдуманная цифра или цитата означала провал. Другие две модели, по сведениям Anthropic, не преодолели этот порог ни в одной попытке.
В ещё одном тесте Opus 5.5 и Opus 5 анализировали возможное слияние двух вымышленных компаний-разработчиков HR-программ. Обе модели подготовили финансовую модель в Excel и презентацию для руководства. Выводы о сделке совпали, однако у Opus 5.5 модель была подробнее, а презентация – проще для чтения. Она завершила работу за 63 минуты против 93 минут у Opus 5, при этом стоимость оказалась ниже на 50%.
Первые пользователи из Deloitte Consulting, Rogo, LexisNexis Legal & Professional, Walleye Capital, Hex, Thomson Reuters Labs, Hebbia и Viktor также сообщили о повышении точности, структурированности ответов и снижении потребления токенов. Эти оценки являются заявлениями самих компаний и не заменяют независимую проверку.
Стиль общения
Одним из заметных изменений Anthropic называет более естественную коммуникацию. По словам компании, Claude Opus 5.5 выносит главное в начало ответа, реже использует профессиональный жаргон и необычные формулировки, а также точнее следует заданным правилам письма. Ранние тестировщики отметили, что ответы стало проще читать и проверять во время долгих рабочих сессий.
В Anthropic считают это не только практическим, но и защитным преимуществом: понятный ход работы и компактные пояснения позволяют пользователю легче контролировать результат. Компании Ramp, Stripe, Box, Chicago Trading Company и Factory в отзывах сообщили, что модель стала менее многословной, лучше формулирует технические документы и требует меньше редакторских правок.
Меры безопасности
Anthropic связывает выпуск модели с подходом «сдерживания передового рубежа» – идеей о том, что развитие ИИ должно идти темпом, позволяющим практикам безопасности опережать рост возможностей систем. Компания считает, что риски нынешнего поколения моделей в целом понятны и управляемы, однако более серьёзные угрозы могут быстро возникнуть по мере роста возможностей ИИ.
Для актуальных моделей компания использует тесты на соответствие заданным правилам, независимые предрелизные оценки и специальные ограничения для областей повышенного риска – в частности, кибербезопасности и биологии. Одновременно Anthropic разрабатывает более строгие подходы для будущих систем: совершенствует фильтрацию сред обучения с подкреплением, механизмы поощрения безопасного поведения, создание сценариев для тренировок и мониторинг интерпретируемости моделей.
В автоматизированном поведенческом аудите Claude Opus 5.5 показала лучшие среди последних моделей результаты почти по всем показателям несогласованного с инструкциями поведения, а также по большинству метрик честности. Компания утверждает, что новинка примерно на 85% реже Claude Opus 5 и Claude Mythos 5.1 пыталась обходить границы изоляции. Все зафиксированные попытки, по её оценке, были низкой серьёзности и сопровождались сообщением со стороны модели.
При этом Anthropic признаёт, что надёжно выявлять каждый возможный сбой до развёртывания модели пока невозможно. Компания наблюдает признаки того, что Opus 5.5 нередко предполагает факт оценки, а это усложняет прогнозирование её поведения в реальных условиях. Поэтому разработчик сочетает тестирование соответствия правилам с техническими ограничениями доступа.
Ограничения для биологии и кибербезопасности
Claude Opus 5.5 стала первой моделью Opus, выпущенной с классом защитных мер, близким к мерам Claude Fable 5.1 в сферах кибербезопасности, биологии и противодействия дистилляции. В ряде чувствительных запросов система прозрачно переключается на другую модель.
В задачах кибербезопасности пользователи смогут находить и исправлять ошибки в собственном коде в рамках обычной разработки, однако большинство специализированных киберзадач будут перенаправляться в Claude Opus 4.8. Проверенные специалисты по кибербезопасности позднее получат доступ к Claude Opus 5.5 через расширяемую программу Cyber Verification Program. В ней предусмотрены три уровня доверенного доступа, включая доступ к моделям Claude Mythos.
В биологических исследованиях Opus 5.5 использует те же ограничения, что и Claude Fable 5.1. Организации, прошедшие проверку, включая академические лаборатории, стартапы и фармацевтические компании, могут подать заявку в Life Sciences Verification Program для работы в областях, которые стандартные защитные меры ограничивают.
Защита от дистилляции и хранение данных
Anthropic также внедрила для Opus 5.5 функцию preserved thinking – «сохранённое рассуждение». Она должна мешать API-пользователям редактировать предыдущий контекст Claude и извлекать ход рассуждений модели для масштабной дистилляции её возможностей. Ограничение распространяется на Claude Fable 5.1 и Claude Opus 5.5 для API-аккаунтов, созданных с 31 августа 2026 года.
Модель доступна с режимом нулевого хранения данных, как и предыдущие версии Claude Opus. Кроме того, для соблюдения требований европейского закона об ИИ в ней используются механизмы маркировки текста. Отключить режим «мышления» в Claude Opus 5.5 нельзя.
Доступность
Claude Opus 5.5 уже доступна на всех платформах Anthropic, включая Amazon Web Services, Google Cloud и Microsoft Azure. В Claude Platform разработчики могут подключить модель под идентификатором claude-opus-5-5. Компания сообщила, что Claude Sonnet 5.5 и Claude Haiku 5.5 выйдут в ближайшие недели и получат многие из заявленных улучшений производительности, эффективности и безопасности.